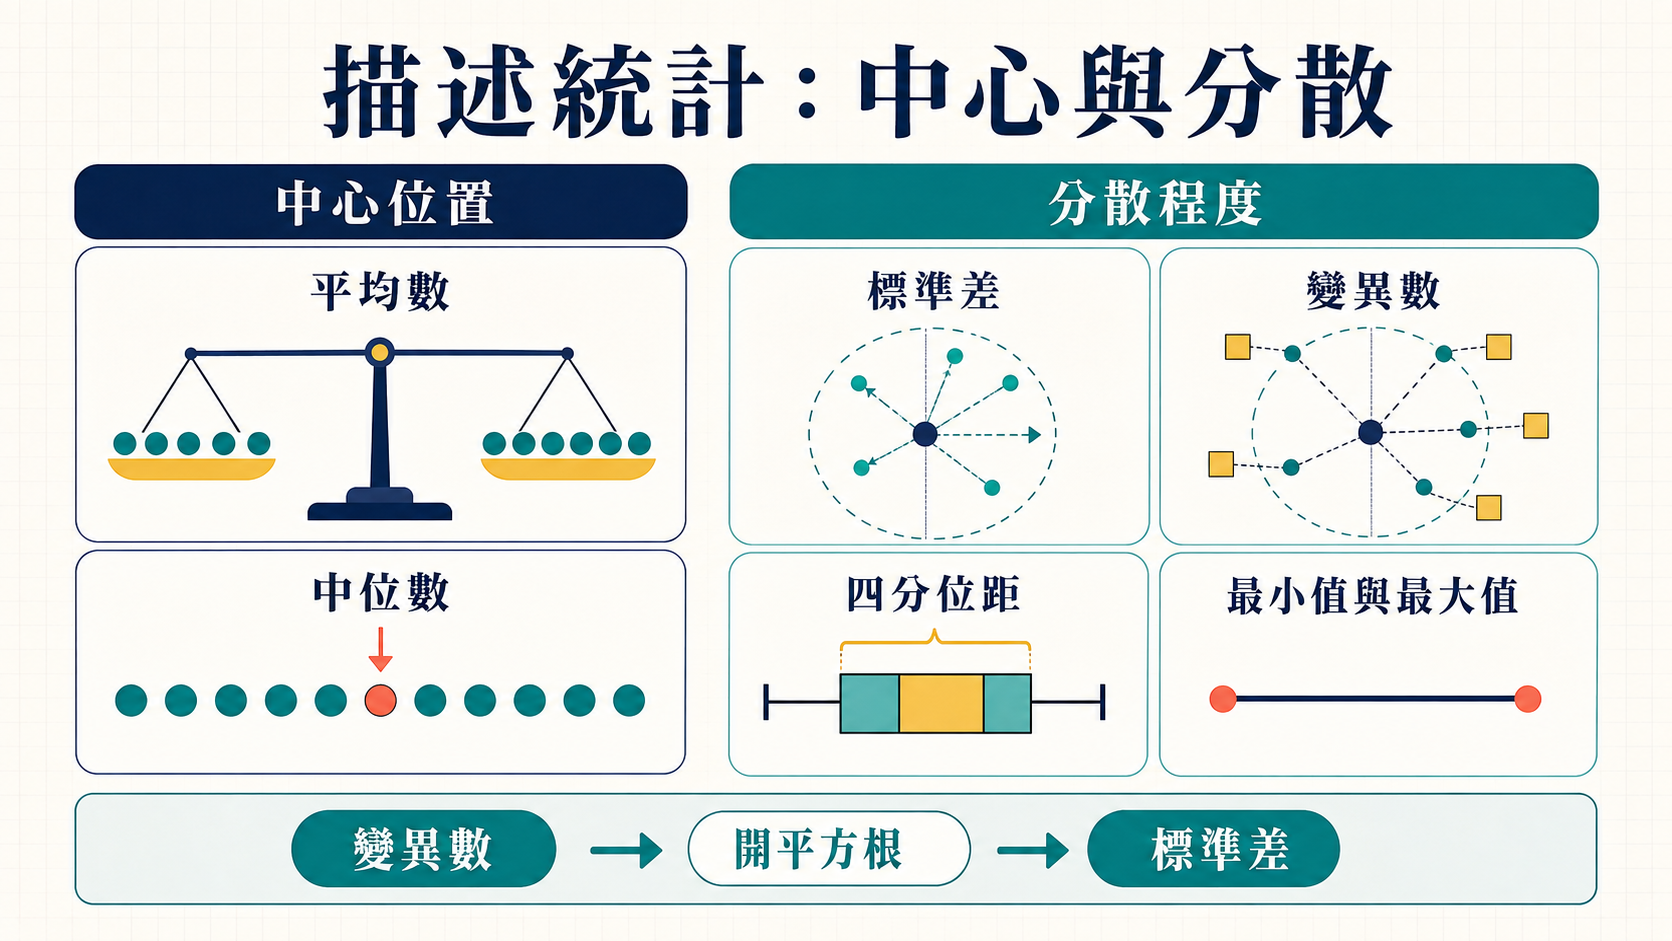
統計第一章內容解釋
可以。這五項統計量都在描述資料,但它們回答的問題不同:
- 平均數、中位數:資料大致集中在哪裡?
- 標準差、變異數、四分位距:資料分散到什麼程度?
- 最小值、最大值:資料涵蓋的範圍有多大?
以下用一組資料貫穿說明。假設調查8家藥局,每日處方箋張數為:
$$ 2,\ 4,\ 4,\ 4,\ 5,\ 5,\ 7,\ 9 $$
一、平均數
平均數是所有數值加總後,除以資料筆數:
$$ \bar{x}=\frac{\sum x_i}{n} $$
這組資料的平均數為:
$$ \bar{x} =\frac{2+4+4+4+5+5+7+9}{8} =\frac{40}{8} =5 $$
所以,這8家藥局平均每天有5張處方箋。
平均數的真實意義
平均數可以理解成資料的「平衡點」。如果把每一家藥局超過平均數的部分,分給低於平均數的藥局,最後每一家都會變成5張。
相對於平均數的差距如下:
| 原始數值 | 與平均數5的差距 |
|---|---|
| 2 | −3 |
| 4 | −1 |
| 4 | −1 |
| 4 | −1 |
| 5 | 0 |
| 5 | 0 |
| 7 | +2 |
| 9 | +4 |
所有差距相加一定等於0:
$$ -3-1-1-1+0+0+2+4=0 $$
平均數的缺點
平均數容易受到極端值影響。
例如,五家藥局的月租為:
$$ 30,000,\ 32,000,\ 35,000,\ 38,000,\ 200,000 $$
平均租金為:
$$ 67,000 $$
但五家藥局中有四家的租金低於38,000元。平均數67,000元并不能很好地代表一般店面的典型租金,因為它被200,000元的極端值拉高了。
因此,平均數通常要搭配中位數及分布一起解讀。
二、中位數
中位數是將資料由小到大排列後,位於正中央的數值。
如果資料筆數是奇數,中位數就是中間那一個值;如果資料筆數是偶數,中位數通常是中間兩個數值的平均。
原資料共有8筆:
$$ 2,\ 4,\ 4,\ 4,\ 5,\ 5,\ 7,\ 9 $$
中間是第4筆與第5筆:
$$ 4,\ 5 $$
因此中位數為:
$$ \frac{4+5}{2}=4.5 $$
中位數的真實意義
中位數把資料分成上下兩半:
- 約一半的觀察值低於或等於中位數。
- 約一半的觀察值高於或等於中位數。
它描述的是資料排序後的中央位置,而不是把數值加總後重新平均分配。
中位數的優點
中位數不容易被極端值影響。
例如:
$$ 30,000,\ 32,000,\ 35,000,\ 38,000,\ 200,000 $$
其中位數為35,000元。即使最後一家店的租金由200,000元增加到500,000元,中位數仍然是35,000元。
所以,面對租金、收入、房價、營業額等容易右偏且可能出現極端值的資料,中位數往往比平均數更能代表「典型情況」。
平均數與中位數如何選擇?
- 分布大致對稱、沒有嚴重離群值:可使用平均數。
- 分布明顯偏斜或存在極端值:中位數通常更穩健。
- 最完整的做法:同時查看平均數、中位數及資料分布。
三、變異數
變異數用來衡量資料相對於平均數的分散程度。
直觀地說,它是在回答:
每一筆資料與平均數之間的距離,整體而言有多大?
第一步:計算每個數值與平均數的差距
這組資料的平均數是5:
| 原始數值 (x_i) | 與平均數的差距 (x_i-\bar{x}) |
|---|---|
| 2 | −3 |
| 4 | −1 |
| 4 | −1 |
| 4 | −1 |
| 5 | 0 |
| 5 | 0 |
| 7 | 2 |
| 9 | 4 |
但是這些差距直接相加等於0,無法表示資料分散程度。
第二步:把每個差距平方
$$ (-3)^2=9,\quad (-1)^2=1,\quad 2^2=4,\quad 4^2=16 $$
| 原始數值 | 差距 | 差距平方 |
|---|---|---|
| 2 | −3 | 9 |
| 4 | −1 | 1 |
| 4 | −1 | 1 |
| 4 | −1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
| 合計 | 0 | 32 |
平方有兩個作用:
- 消除正負差距互相抵銷的問題。
- 讓距離平均數較遠的觀察值受到較大的權重。
母體變異數
如果這8家藥局就是研究所關心的完整母體,母體變異數為:
$$ \sigma^2=\frac{\sum(x_i-\mu)^2}{N} $$
代入資料:
$$ \sigma^2=\frac{32}{8}=4 $$
所以母體變異數為4。
變異數的真實意義
變異數就是:
各觀察值與平均數之「平方距離」的平均。
這裡最重要的是「平方距離」。變異數不是一般距離的平均,也不能直接說這些藥局平均與平均值相差4張。
因為原始單位是「張」,平方後的變異數單位變成:
$$ \text{張}^2 $$
「平方張數」在現實中很難直觀解釋。因此,變異數非常適合數學運算及建立統計模型,但通常不適合直接向一般讀者描述資料分散程度。
這也是我們需要標準差的主要原因。
四、標準差
標準差是變異數開平方根:
$$ \sigma=\sqrt{\sigma^2} $$
上述資料的母體變異數是4,所以標準差為:
$$ \sigma=\sqrt{4}=2 $$
原始資料的單位是「張」,標準差的單位也是「張」。
標準差的真實意義
標準差可以較直觀地理解為:
資料與平均數之間的典型距離。
這組資料的平均數是5,標準差是2,表示各家藥局每日處方箋數量與平均數5張的差距,典型幅度大約是2張。
但這是一種直觀解釋,不代表每一家藥局都剛好距離平均數2張。原始資料實際與平均數的距離是:
$$ 3,\ 1,\ 1,\ 1,\ 0,\ 0,\ 2,\ 4 $$
這些距離並不都是2。
更精確地說,標準差是:
各觀察值與平均數之平方距離的平均,再取平方根。
因此,標準差又可以稱為「均方根偏差」:
$$ \sigma= \sqrt{ \frac{\sum(x_i-\mu)^2}{N} } $$
為什麼不直接計算絕對距離的平均?
如果把每個差距取絕對值,再計算平均,會得到「平均絕對偏差」。這也是合理的離散指標。
不過,統計學常使用平方差,原因包括:
- 平方差具有良好的數學性質。
- 可以對較大的偏離給予較強懲罰。
- 能與常態分布、迴歸分析、ANOVA等方法自然連結。
- 平方差容易進行微分與模型最佳化。
因此,變異數和標準差成為許多統計方法的核心。
標準差大或小代表什麼?
假設兩個地區的藥局平均每日處方箋都是50張。
甲地區:
$$ 48,\ 49,\ 50,\ 51,\ 52 $$
乙地區:
$$ 10,\ 30,\ 50,\ 70,\ 90 $$
兩組平均數都是50,但乙地區的標準差明顯較大。
這表示:
- 甲地區的藥局表現比較集中、彼此相近。
- 乙地區的藥局差異較大,有些很低、有些很高。
所以,平均數相同不代表資料分布相同。標準差提供了平均數無法呈現的「個體差異」資訊。
標準差不是什麼?
標準差不是:
- 測量錯誤。
- 抽樣誤差。
- 平均數的誤差。
- 百分比。
- 每一筆資料與平均數的實際平均距離。
- 資料一定落在某個範圍內的保證。
例如「平均年齡40歲,標準差8歲」,不表示每個人的年齡都介於32至48歲。它只表示資料相對於平均數的典型分散幅度約為8歲。
五、母體變異數與樣本變異數
前面的計算把8家藥局視為完整母體,所以除以 (N)。
但論文研究通常只取得母體中的一部分樣本。此時,樣本變異數通常寫成:
$$ s^2=\frac{\sum(x_i-\bar{x})^2}{n-1} $$
本例的離均差平方和為32,樣本數為8,因此:
$$ s^2=\frac{32}{8-1} =\frac{32}{7} \approx4.57 $$
樣本標準差為:
$$ s=\sqrt{4.57}\approx2.14 $$
因此,同一組資料可能得到:
- 視為完整母體:變異數 (=4),標準差 (=2)。
- 視為母體樣本:變異數 (\approx4.57),標準差 (\approx2.14)。
為什麼樣本變異數除以 (n-1)?
因為樣本平均數是由同一組樣本估計出來的。離均差受到一項限制:
$$ \sum(x_i-\bar{x})=0 $$
只要知道前 (n-1) 個差距,最後一個差距就被決定了。因此,真正能自由變動的資訊只有 (n-1) 個,稱為 (n-1) 個自由度。
更重要的是,如果直接除以 (n),樣本通常會低估母體變異程度。除以 (n-1) 的修正稱為 Bessel校正,可以讓樣本變異數成為母體變異數的不偏估計量。
這裡要注意:
- 樣本變異數 (s^2) 是母體變異數 (\sigma^2) 的不偏估計。
- 樣本標準差 (s) 本身並不是完全不偏的估計量。
一般統計軟體在計算樣本資料的標準差時,通常採用 (n-1)。
六、四分位數與四分位距
將資料從小到大排列後,可以用四分位數將資料大致分成四個部分。
- 第一四分位數 (Q_1):約25%的資料位於它以下。
- 第二四分位數 (Q_2):中位數,約50%的資料位於它以下。
- 第三四分位數 (Q_3):約75%的資料位於它以下。
四分位距為:
$$ IQR=Q_3-Q_1 $$
它代表中間50%資料所涵蓋的範圍。
以原始資料為例:
$$ 2,\ 4,\ 4,\ 4,\ 5,\ 5,\ 7,\ 9 $$
若使用「上下兩半各自取中位數」的方法:
下半部為:
$$ 2,\ 4,\ 4,\ 4 $$
所以:
$$ Q_1=\frac{4+4}{2}=4 $$
上半部為:
$$ 5,\ 5,\ 7,\ 9 $$
所以:
$$ Q_3=\frac{5+7}{2}=6 $$
因此:
$$ IQR=6-4=2 $$
四分位距的真實意義
四分位距表示中間50%的資料分散範圍。
本例中,中間50%的每日處方箋數大致分布在4至6張之間,範圍寬度為2張。
四分位距不太受到極端值影響,因此特別適合描述偏斜資料或含有離群值的資料。
例如:
$$ 10,\ 11,\ 12,\ 13,\ 100 $$
即使最大值由100變成1,000,中間位置附近的資料沒有改變,四分位距通常也不會像全距或標準差那樣劇烈改變。
四分位數為什麼有時不一樣?
不同統計軟體可能使用不同的百分位數計算方法,尤其在樣本很小時,算出的 (Q_1) 與 (Q_3) 可能略有差異。
這不一定是計算錯誤,而可能是演算法定義不同。因此,正式研究應:
- 使用同一套軟體與計算方法。
- 記錄軟體版本及分析設定。
- 不要手算一種方法後,直接拿來與另一套軟體比較。
七、最小值與最大值
最小值是資料中最低的觀察值,最大值是最高的觀察值。
原始資料為:
$$ 2,\ 4,\ 4,\ 4,\ 5,\ 5,\ 7,\ 9 $$
因此:
$$ \min=2,\qquad \max=9 $$
全距為:
$$ \text{Range}=\max-\min=9-2=7 $$
最小值與最大值能告訴我們什麼?
它們可以幫助研究者快速了解:
- 資料涵蓋的範圍。
- 是否出現不可能的數值。
- 是否可能存在極端值。
- 資料輸入或編碼是否有錯誤。
例如:
- Likert量表應介於1至5分,卻出現55,可能是輸入錯誤。
- 年齡資料出現−3歲,顯然不合理。
- 每月租金出現0元,可能是真的免租,也可能是遺漏值被錯誤編碼成0。
因此,最小值與最大值不只是描述統計,也是一種重要的資料品質檢查。
最小值與最大值的限制
最小值和最大值完全由兩筆資料決定,對極端值非常敏感。
例如:
$$ 10,\ 11,\ 12,\ 13,\ 14 $$
全距為:
$$ 14-10=4 $$
如果最大值14被改成100,全距就變成:
$$ 100-10=90 $$
雖然其他四筆資料完全沒有改變,全距卻從4增加至90。因此,不能只使用最小值、最大值或全距描述資料分散程度。
八、標準差與四分位距如何選擇?
兩者都描述資料分散程度,但基礎不同:
| 指標 | 依據 | 是否容易受極端值影響 | 通常搭配 |
|---|---|---|---|
| 標準差 | 每筆資料與平均數的平方距離 | 是 | 平均數 |
| 四分位距 | 中間50%資料的位置 | 否 | 中位數 |
| 全距 | 最大值與最小值 | 非常容易 | 最小值、最大值 |
一般原則是:
- 資料大致對稱、沒有嚴重離群值:報告平均數與標準差。
- 資料明顯偏斜或有離群值:報告中位數與四分位距。
- 想呈現完整觀察範圍:另外報告最小值與最大值。
不能只因為資料「沒有通過常態性檢定」,就機械式地全部改報中位數。還應查看直方圖、箱形圖、Q–Q圖、樣本數、偏態程度及後續分析目的。
九、標準差與常態分布的關係
如果資料近似常態分布,平均數與標準差可以進一步描述資料落點:
- 約68%的資料位於平均數正負1個標準差內。
- 約95%的資料位於平均數正負2個標準差內。
- 約99.7%的資料位於平均數正負3個標準差內。
假設藥師年齡近似常態分布:
$$ 平均數=40歲,\qquad 標準差=5歲 $$
便可大致推測:
- 約68%介於35至45歲。
- 約95%介於30至50歲。
- 約99.7%介於25至55歲。
但這些比例只有在資料近似常態分布時才適用。資料偏斜或具有多個高峰時,不能直接套用。
標準差本身仍然可以計算,但「平均數正負兩個標準差包含約95%資料」未必成立。
十、一張表掌握五個指標
| 統計量 | 回答的問題 | 優點 | 主要限制 |
|---|---|---|---|
| 平均數 | 資料的平衡點在哪裡? | 使用全部數值,適合後續統計分析 | 容易受極端值影響 |
| 中位數 | 排序後的中央位置在哪裡? | 不易受極端值影響 | 沒有充分使用每個數值的距離資訊 |
| 變異數 | 平均平方距離有多大? | 是許多統計模型的數學基礎 | 單位被平方,難以直接解釋 |
| 標準差 | 資料與平均數的典型距離多大? | 與原始資料單位相同 | 容易受離群值影響 |
| 四分位距 | 中間50%的資料範圍多寬? | 對偏態與離群值較穩健 | 不呈現兩端資料的變異 |
| 最小值、最大值 | 實際觀察範圍到哪裡? | 直觀,也能協助檢查錯誤 | 完全受兩端數值影響 |
最重要的理解是:
平均數告訴我們資料的中心;標準差告訴我們資料通常離這個中心多遠;變異數則是這些距離平方後的平均,是標準差背後的數學基礎。
在論文中,較完整的寫法可以是:
受訪藥師的平均年齡為40.2歲,標準差為8.3歲,中位數為39.0歲,四分位距為12.0歲,年齡範圍為25至68歲。
但是,不能只列出數字。還應查看平均數與中位數是否差距明顯、標準差是否過大,以及最小值、最大值是否合理,才能真正理解資料的分布情況。
前面的說明只講到「常態分布」,但沒有真正說明「常態性檢定怎麼做,以及為什麼不能只看 p 值」。這一段應該補上,而且對後面的 t 檢定、ANOVA、迴歸分析非常重要。
常態性檢定是什麼?
常態性檢定是用來評估資料是否明顯偏離常態分布的統計檢定。
常見方法包括:
- Shapiro–Wilk檢定
- Kolmogorov–Smirnov檢定
- Anderson–Darling檢定
- 圖形判斷:直方圖與Q–Q圖
其中,Shapiro–Wilk檢定是常見且通常較推薦的方法。
它的假設為:
$$ H_0:資料來自常態分布 $$
$$ H_1:資料不是來自常態分布 $$
因此:
- (p < .05):拒絕虛無假設,表示資料有統計證據顯示偏離常態。
- (p \geq .05):無法拒絕虛無假設,表示尚未發現明顯偏離常態的證據。
但要特別注意:
(p \geq .05) 不等於證明資料符合常態分布。
它只能表示目前的樣本沒有提供足夠證據否定常態性。
為什麼不能只看常態性檢定的 p 值?
常態性檢定對樣本數非常敏感。
小樣本的問題
樣本很小時,檢定力不足。即使資料明顯偏斜,常態性檢定也可能得到:
$$ p>.05 $$
這不一定表示資料真的近似常態,而可能是樣本太少,檢定無法發現問題。
例如只有15位受訪者時,即使直方圖看起來有些偏斜,Shapiro–Wilk檢定仍可能不顯著。
大樣本的問題
樣本很大時,常態性檢定會非常敏感。即使資料只有輕微偏離常態,仍可能得到:
$$ p<.05 $$
例如有2,000筆資料時,分布雖然視覺上接近鐘形,只因存在些微偏態,檢定也可能顯著。
但這種輕微偏離未必會嚴重影響t檢定、ANOVA或迴歸分析。
因此,不能使用以下機械式規則:
Shapiro–Wilk檢定顯著,所以資料不能分析。
這種結論通常過度簡化。
常態性應該如何判斷?
較合理的方式是同時使用「統計檢定」與「圖形檢查」。
1. 直方圖
直方圖可以觀察資料是否:
- 大致對稱
- 呈單峰分布
- 明顯左偏或右偏
- 存在多個高峰
- 出現離群值
但直方圖會受到組距設定影響。同一組資料使用不同組距,外觀可能不同,因此不能只看一張直方圖就作結論。
2. Q–Q圖
Q–Q圖會比較實際資料分位數與理論常態分布分位數。
判讀原則:
- 資料點大致沿對角線排列:分布接近常態。
- 兩端明顯偏離:可能有厚尾、薄尾或離群值。
- 整體呈彎曲形狀:可能存在偏態。
- 少數點遠離線段:可能存在離群值。
Q–Q圖不是要求每一點都完全在線上。實際樣本一定會有些波動,應關注明顯且有系統性的偏離。
3. 偏態與峰度
偏態反映分布是否左右不對稱:
- 正偏態:右側尾巴較長,例如收入、租金。
- 負偏態:左側尾巴較長,例如非常簡單的考試成績。
- 接近0:分布較為對稱。
峰度反映分布尾端及極端值特性。不同軟體可能報告一般峰度或超額峰度,解讀前應先確認軟體定義。
不能只靠「偏態與峰度必須介於某個固定範圍」判斷常態性。不同文獻提出的門檻不一致,而且資料是否足以進行分析,還與樣本數及方法穩健性有關。
4. 常態性檢定
Shapiro–Wilk檢定可以作為輔助證據,但不應成為唯一判準。
完整判斷可以包含:
- Shapiro–Wilk檢定
- 直方圖
- Q–Q圖
- 偏態與峰度
- 離群值
- 樣本數
- 後續統計方法對常態偏離的敏感程度
到底是哪個變項需要符合常態分布?
這是最容易被誤解的地方。
不是所有統計方法都要求「所有原始變項符合常態分布」。不同方法所要求的對象不同。
t檢定
獨立樣本t檢定關心的是:
依變項在各組中的分布是否存在嚴重偏離。
例如比較都市與鄉村藥局的營業額,應分別觀察都市組與鄉村組的營業額分布,而不是把兩組混在一起做一次常態性檢定。
成對樣本t檢定關心的則是:
每位受試者前後差值是否近似常態。
它不要求前測與後測各自都符合常態分布。
ANOVA
ANOVA的常態性假設主要針對:
各組誤差或模型殘差是否近似常態。
並不是要求自變項符合常態分布。自變項通常本來就是組別,不可能形成常態分布。
線性迴歸
線性迴歸通常關心的是:
在模型設定下,誤差項或殘差是否近似常態。
它不要求:
- 每個自變項都符合常態分布
- 依變項本身一定完全常態
- 類別控制變項符合常態
例如「店面租金」可能呈右偏,但這不代表不能放進線性迴歸。真正需要檢查的是模型形式、殘差、同質變異、線性關係及高影響值。
此外,殘差常態性主要影響小樣本下的信賴區間與顯著性檢定,並不是普通最小平方法估計迴歸係數的必要條件。
卡方檢定與邏輯斯迴歸
通常不要求原始資料符合常態分布:
- 卡方檢定分析的是類別次數。
- 邏輯斯迴歸的依變項是二元結果。
因此,不能在進行所有統計方法之前,一律先做常態性檢定。
資料不符合常態分布,應該怎麼辦?
發現資料偏離常態後,不應立即改用無母數方法。應先判斷偏離的原因與嚴重程度。
第一步:檢查資料錯誤
先確認是否存在:
- 輸入錯誤
- 單位錯誤
- 遺漏值被編碼為0
- 不可能的極端數值
- 重複資料
如果是資料錯誤,應回到原始資料修正,而不是使用統計方法掩蓋問題。
第二步:判斷離群值是否真實
離群值可能是:
- 輸入錯誤
- 測量錯誤
- 真實但少見的觀察值
- 代表不同群體的個案
不能只因離群值使常態性檢定顯著就將它刪除。刪除必須有明確、事前或可辯護的資料品質理由。
第三步:考慮方法是否具有穩健性
在樣本適當、各組樣本數相近,且沒有嚴重離群值時,t檢定與ANOVA對輕度常態偏離通常具有一定穩健性。
但這不代表可以完全忽略分布。若出現嚴重偏態、小樣本、組間樣本數非常不均或極端值,影響就可能較大。
第四步:選擇合適處理方式
可能的方法包括:
- 報告中位數與四分位距
- 使用Welch t檢定或Welch ANOVA
- 使用穩健標準誤
- 使用Bootstrap信賴區間
- 進行資料轉換,例如對數轉換
- 使用無母數方法
- 改用符合資料分布的模型
例如,藥局數量屬於計數資料,與其為了符合常態而硬做轉換,有時使用Poisson迴歸或負二項迴歸更符合資料產生機制。
無母數方法不等於完全沒有假設
常見誤解是:
資料不符合常態,所以改用無母數方法,便不需要任何假設。
實際上,無母數方法仍有自己的條件。
例如:
- Mann–Whitney U檢定要求觀察值獨立。
- 如果要把Mann–Whitney U解釋為中位數差異,通常還需要兩組分布形狀相近。
- Wilcoxon符號等級檢定對差值分布也有相關要求。
- 各方法仍須考慮測量尺度、抽樣方式與資料結構。
因此,「無母數」不是完全沒有假設,而是對母體分布形式的要求較少。
論文中可以怎麼寫?
不建議只寫:
經Shapiro–Wilk檢定,所有變項均達常態分布。
這句話有兩個問題:
- (p>.05)不能證明資料「達到」常態分布。
- 未說明檢查的是原始變項、分組資料還是模型殘差。
較合理的寫法是:
本研究以Q–Q圖、直方圖及Shapiro–Wilk檢定評估模型殘差的常態性。雖然Shapiro–Wilk檢定達顯著水準,但Q–Q圖僅顯示尾端輕微偏離,未發現嚴重離群值。考量樣本數及分析方法的穩健性,仍採用原定分析,並以Bootstrap信賴區間進行敏感度檢查。
如果資料沒有明顯問題,也可以寫:
Q–Q圖顯示各組資料大致沿理論常態線分布,未見嚴重偏態或極端離群值;Shapiro–Wilk檢定亦未提供明顯偏離常態分布的證據。
最重要的結論
常態性檢定不是一個「通過/不通過」的資格考試。
正確的判斷邏輯是:
先確認統計方法要求哪一部分近似常態,再結合圖形、檢定、離群值、樣本數與方法穩健性作整體判斷。
尤其要記住:
- (p<.05)不代表資料完全不能分析。
- (p\geq.05)不代表已經證明資料符合常態。
- 大樣本容易檢出沒有實務影響的微小偏離。
- 小樣本可能無法檢出真正存在的偏離。
- 迴歸通常檢查殘差,不是要求所有變項常態。
- 不符合常態不代表一定要改用無母數方法。
- 常態性判斷不能只看一個p值。
留言
點擊「載入留言」後顯示 Disqus。