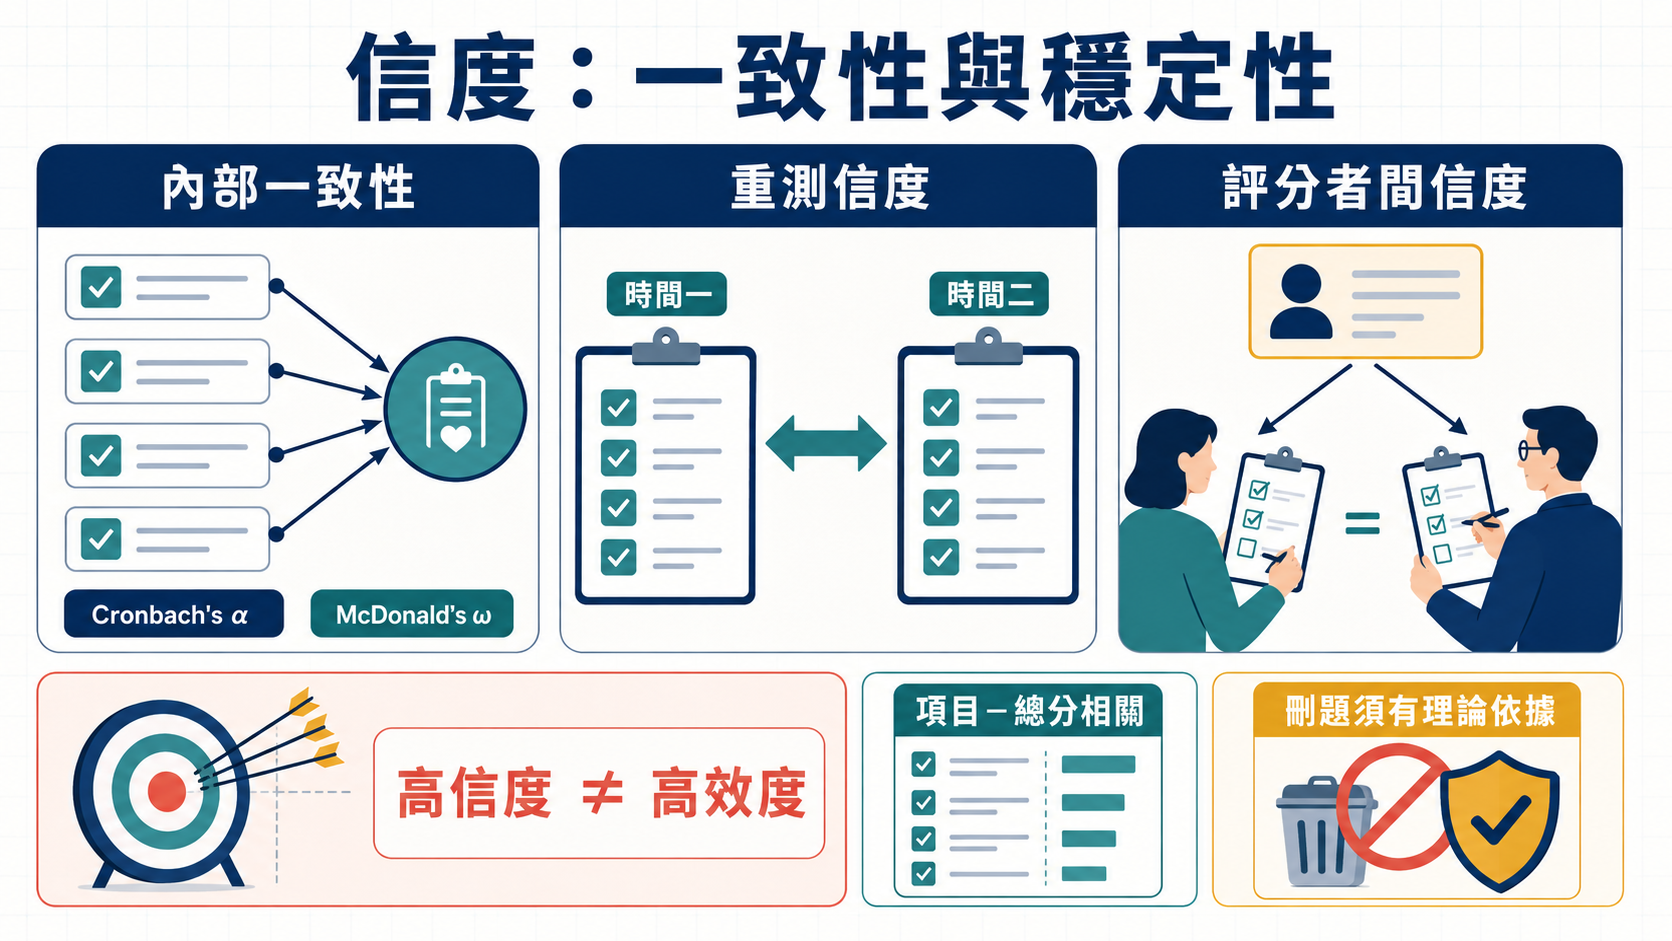
第二章第二節信度:量表的測量結果是否足夠一致與穩定?
研究者使用四道題目測量「對藥局選址系統的信任」:
- 我相信系統提供的資料是正確的。
- 我相信系統的選址評分具有參考價值。
- 我願意根據系統結果進行選址。
- 我喜歡系統使用的顏色。
前三題可能與系統信任有關,第四題則比較接近介面美感。如果直接將四題相加,形成的分數可能沒有清楚意義。
因此,量表建立後,研究者需要評估它的信度。
一、什麼是信度?
信度是指測量結果的一致性、穩定性或可重複程度。
簡單來說,信度想回答的是:
如果我們用這套量表進行測量,得到的分數是否穩定,而不是充滿隨機波動?
假設一台體重計在同一分鐘內測量同一個人,分別顯示:
$$ 60,\ 74,\ 53,\ 68\text{公斤} $$
即使其中一次剛好接近真實體重,這台體重計仍然不可靠,因為測量結果變化太大。
問卷量表也是如此。如果題目容易被誤解、受當下情緒影響,或不同題項彼此毫無關係,受訪者的分數便可能包含大量測量誤差。
二、觀察分數包含什麼?
古典測驗理論通常將觀察到的分數表示為:
$$ X=T+E $$
其中:
- (X):實際觀察到的分數
- (T):真實分數
- (E):測量誤差
例如,一位藥師對系統的真實信任程度相對穩定,但其問卷分數可能受到下列因素影響:
- 當天心情
- 作答環境
- 題目措辭
- 是否看懂反向題
- 是否急著完成問卷
- 記憶或注意力
- 系統操作經驗是否剛好發生變化
因此,實際得到的分數並不完全等於真實程度。
信度越高,代表觀察分數中的隨機誤差相對較少;信度越低,代表分數受到測量誤差影響較大。
但這裡要特別注意:
信度高不代表完全沒有測量誤差,也不代表量表測到的就是研究者想測的構念。
三、信度與效度有什麼差別?
信度關心的是測量結果是否穩定一致;效度關心的是量表是否真正測到預定構念。
可以用射箭來理解:
- 每一箭都射在相近的位置,但全部偏離靶心:信度高、效度低。
- 每一箭分散在不同位置:信度低,效度通常也難以成立。
- 每一箭都集中在靶心附近:信度與效度都較好。
例如,一份「系統信任量表」的題目全部都在詢問介面是否漂亮。受訪者對這些題目的回答可能非常一致,因此信度很高;但它實際測量的可能是介面美感,而不是系統信任,因此效度不足。
所以:
信度是效度的重要條件之一,但高信度不能自動證明高效度。
四、信度不是只有一種
不同信度回答不同問題。
| 信度類型 | 主要問題 |
|---|---|
| 內部一致性 | 同一量表中的題項是否具有合理一致性? |
| 重測信度 | 相同對象在不同時間的測量結果是否穩定? |
| 評分者間信度 | 不同評分者對相同對象的評分是否一致? |
| 平行形式信度 | 兩份測量相同構念的平行版本是否一致? |
問卷研究最常報告的是內部一致性,但不能因此認為Cronbach’s α就是所有信度的代名詞。
五、內部一致性是什麼?
內部一致性用來評估同一量表中的題項是否共同反映某個構念。
假設使用四個題目測量知覺有用性:
- 系統能提升我的選址效率。
- 系統能改善我的選址決策。
- 系統能幫助我比較不同地點。
- 系統能減少蒐集資料的時間。
如果這些題目確實都與知覺有用性有關,認為系統有幫助的受訪者,通常會在多數題目上給予較高分;認為系統沒有幫助的受訪者,則可能在多數題目上給予較低分。
也就是說,題項之間應具有合理程度的共同變動。
內部一致性過低可能表示:
- 題目測量不同構念。
- 題目文字不清楚。
- 受訪者對題目的理解不一致。
- 反向題尚未重新編碼。
- 題目與研究族群不相符。
- 題目數量太少。
- 受訪者回答缺乏變異。
但是,題項相關越高也不一定越好。如果不同題目幾乎只是重複相同句子,內部一致性可能非常高,量表內容卻很狹窄。
六、Cronbach’s α是什麼?
Cronbach’s α是最常見的內部一致性指標之一。
其概念是比較:
- 各題分數的變異
- 所有題目形成的總分變異
- 題項數量
- 題項之間共同變動的程度
其中一種常見公式為:
$$ \alpha= \frac{k}{k-1} \left( 1-\frac{\sum_{i=1}^{k}s_i^2}{s_T^2} \right) $$
其中:
- (k):題項數量
- (s_i^2):第 (i) 題的變異數
- (s_T^2):量表總分的變異數
初學時不必背公式,但要理解:
α會受到題項之間相關程度及題目數量共同影響。
當題項之間具有較強的正相關,或者題目數量增加時,α通常會提高。
七、Cronbach’s α如何解讀?
實務研究中常見以下參考方式:
| α值 | 常見初步解讀 |
|---|---|
| 低於.60 | 內部一致性可能不足 |
| .60至.69 | 偏低,探索性研究中可能暫時接受 |
| .70至.79 | 通常視為可接受 |
| .80至.89 | 良好 |
| .90以上 | 很高,但須檢查題目是否重複 |
這些門檻不是自然法則,也不是所有研究都必須遵守的固定及格線。
α值的判斷還要考慮:
- 研究目的
- 構念性質
- 題目數量
- 樣本特徵
- 量表發展階段
- 使用後果
- 所屬研究領域
例如,初步探索性研究與高風險臨床決策工具對信度的要求不應完全相同。
因此,不宜只寫:
Cronbach’s α大於.70,所以量表具有良好信度。
更嚴謹的說法是:
本量表在目前樣本中呈現可接受的內部一致性。
這種說法清楚限制了推論範圍。
八、α值高代表什麼?
高α通常表示題項之間具有較強的共同變動。
但它不一定表示:
- 量表只有一個構面。
- 題項都測量同一個心理概念。
- 量表具有良好效度。
- 量表可以用於其他族群。
- 測量結果在不同時間都穩定。
- 題目設計沒有問題。
高α可能只是因為題目很多
α會受到題項數量影響。即使題目之間只有中等程度的相關,只要題目很多,α也可能變高。
例如,一份50題的問卷可能得到很高的α,但不代表50題都必要,也不代表量表只有一個構面。
高α可能來自題目重複
例如:
- 我認為這套系統很有用。
- 我覺得這套系統對我有幫助。
- 我認為使用這套系統是有益的。
- 這套系統對我而言具有用途。
這些題目的文字略有不同,但內容高度重複。它們可能產生非常高的α,卻沒有充分涵蓋知覺有用性的不同面向。
如果α高達.95或.98,不一定值得高興,反而要檢查題目是否過度重複。
九、α值低代表什麼?
低α表示目前樣本中的題項缺乏足夠的共同變動,但不能直接斷定某一道題目一定錯誤。
可能原因包括:
(一)反向題沒有重新編碼
這是最常見的資料處理錯誤之一。
例如其他題目高分都代表高信任,但反向題高分代表低信任。如果沒有反向計分,該題可能與其他題目呈負相關,使α明顯下降。
(二)量表包含不同構面
例如將「易用性」「有用性」與「使用意願」的題目混在一起計算一個α。即使這些構念彼此相關,它們仍可能不是同一個量表。
此時應根據理論與因素分析區分構面,而不是只刪除與其他題目相關較低的題目。
(三)題目數量太少
兩題或三題量表即使題項具有合理相關,α也可能不高。這是因為α受到題數影響。
對兩題量表而言,報告兩題之間的相關或Spearman–Brown係數可能更有意義。
(四)題目表達不清
例如雙重否定、模糊詞語、過度專業或同時詢問兩件事情,都可能使受訪者產生不同理解。
(五)樣本回答缺乏變異
如果幾乎所有人都選擇4分或5分,題項間的相關可能受到限制。這可能是天花板效應,也可能是樣本過於同質。
(六)樣本不適合量表
原量表可能在一般消費者中具有良好內部一致性,但不代表同樣適用於藥師、長者或特定專業族群。
十、McDonald’s ω是什麼?
McDonald’s ω也是評估內部一致性的常用指標。
相較於Cronbach’s α,ω通常建立在因素模型上,會考慮不同題項對共同因素的負荷量。
簡單來說:
- α常隱含各題對構念貢獻相近的假設。
- ω允許不同題項對構念具有不同程度的貢獻。
假設四個題目測量系統信任,但因素負荷量分別為:
$$ .85,\ .78,\ .62,\ .41 $$
這代表四個題目與共同構念的關係並不相同。ω可以在估計內部一致性時反映這些差異。
因此,當題項因素負荷量不相等時,ω通常比α具有更合理的模型基礎。
十一、應該報告α還是ω?
若條件允許,現代量表研究可以同時報告:
- Cronbach’s α
- McDonald’s ω
- 兩者的信賴區間
原因是:
- α容易與過去研究比較。
- ω在許多常見情況下較符合實際測量結構。
- 兩個指標如果結果接近,可以提供互補證據。
- 如果兩者差異明顯,可能提示題項負荷量不均或模型結構需要檢查。
但是,ω也不是自動正確。它仍依賴所建立的因素模型。如果量表實際上具有多個因素,卻硬套成單因素模型,計算出的ω同樣可能被錯誤解讀。
所以:
α與ω都必須在合理的測量模型下解讀,不能取代因素分析與效度檢驗。
十二、信度係數不是固定屬性
研究者常寫:
某量表的信度為.85。
這句話容易讓人誤以為信度是量表永久不變的特徵。
實際上,信度係數會隨下列因素改變:
- 受試者族群
- 樣本異質性
- 語言版本
- 題目修改
- 施測方式
- 研究情境
- 測量時間
- 分數計算方式
同一份量表在大學生樣本中的α可能是.88,在高齡者樣本中可能只有.66。這不一定代表計算錯誤,而可能是兩個族群對題目的理解或分數變異不同。
因此,更精確的說法是:
這組量表分數在本研究樣本中呈現某種程度的信度。
不是說量表本身永遠具有固定信度。
十三、修正後項目-總分相關是什麼?
修正後項目-總分相關,英文常寫作 corrected item-total correlation。
它計算的是:
某一道題目的分數,與其餘題目總分之間的相關。
為什麼要排除該題本身?
如果把某題也包含在總分中,再計算該題與總分的相關,會因為總分本來就包含該題而產生部分機械性相關。因此,修正後項目-總分相關會先從總分中排除該題。
例如,一個量表有四題:
$$ X_1,\ X_2,\ X_3,\ X_4 $$
檢查第一題時,計算的是:
$$ X_1 $$
與
$$ X_2+X_3+X_4 $$
之間的相關。
如果相關很低,表示第一題與其餘題目共同測量內容的關係較弱。
十四、修正後項目-總分相關如何判斷?
實務上有時會將.30作為初步參考:
- 高於.30:通常表示題目與量表其餘部分具有一定一致性。
- 低於.30:可能需要進一步檢查。
- 負值:尤其需要確認反向題編碼、資料錯誤或題目方向。
但.30不是絕對刪題標準。
某題的相關較低可能是因為:
- 題目表達不清。
- 題目測量不同構面。
- 題目是反向題。
- 題目代表構念中較獨特但重要的面向。
- 樣本對該題沒有足夠分數變異。
- 量表本身不是單一構面。
因此,看到低項目-總分相關時,應先找原因,而不是立刻刪除。
十五、「刪除該題後的α」如何解讀?
統計軟體通常會提供「Cronbach’s Alpha if Item Deleted」,也就是刪除某題後的α值。
假設原量表的α為.76:
| 題項 | 修正後項目-總分相關 | 刪題後α |
|---|---|---|
| 題目1 | .62 | .68 |
| 題目2 | .58 | .70 |
| 題目3 | .55 | .71 |
| 題目4 | .18 | .83 |
刪除題目4後,α從.76提高到.83,表示題目4可能與其他題目的共同變動較弱。
但是,這只能提示研究者進一步檢查,不能單獨證明題目4必須刪除。
研究者還應檢查:
- 題目4是否忘記反向計分?
- 題目4是否翻譯錯誤或語意模糊?
- 題目4是否屬於不同構面?
- 題目4是否代表構念的重要內容?
- 因素分析中題目4的負荷量如何?
- 刪除後是否降低內容效度?
- 原量表是否允許刪題?
- 刪題決策是否能在另一個樣本中重現?
不好的寫法
為提高Cronbach’s α,本研究刪除題目4。
這種說法把提高統計數字當成刪題目的,方法論依據不足。
較合理的寫法
題目4的修正後項目-總分相關偏低,且刪除後內部一致性有所提高。進一步檢查發現該題在預試訪談中容易被誤解,因素負荷量亦偏低。考量其內容已由其他題項涵蓋,因此予以刪除。
這種寫法同時提供語意、理論與統計理由。
十六、平均題間相關
除了α與ω,也可以檢查平均題間相關,也就是所有題項兩兩相關的平均。
它可以幫助判斷:
- 題項之間是否幾乎沒有關係。
- 題項是否高度重複。
- α很高是否主要由大量題目造成。
若平均題間相關過低,可能表示題目缺乏共同性;若過高,可能表示題目重複。
適合的範圍會依構念寬窄而不同:
- 構念較廣,題項相關可能較低。
- 構念較窄,題項相關可能較高。
因此,不能使用一個固定門檻判斷所有量表。
十七、重測信度是什麼?
重測信度評估相同受試者在兩個時間點的測量結果是否穩定。
例如,研究者在第一週測量100位藥師的「一般科技焦慮」,兩週後再次使用相同量表測量。如果該構念在這段時間理論上應保持相對穩定,兩次分數應具有較高一致性。
重測信度關心的是:
同一個人在不同時間的相對位置是否穩定?
它通常可以使用相關係數或組內相關係數評估,具體方法取決於研究目的與資料結構。
十八、重測間隔應該多長?
時間間隔太短可能產生記憶效應。受訪者記得上次的答案,因此兩次測量看似高度一致。
時間間隔太長則可能發生真實改變。例如:
- 接受教育訓練
- 實際使用新系統
- 工作環境改變
- 政策或市場事件發生
- 心理狀態自然變化
此時兩次分數不同,不一定是量表不可靠,也可能是構念真的改變。
所以,重測間隔沒有適用所有研究的固定答案,應依構念穩定性決定。
例如:
- 人格特質通常預期較穩定。
- 情緒、疼痛與滿意度可能快速變化。
- 使用意願可能因實際使用經驗而改變。
十九、內部一致性不能取代重測信度
一份量表可能具有很高的α,但隔一週再測時,分數變化很大。
這表示:
- 同一時間點內,題項回答彼此一致。
- 不同時間點之間,測量結果卻不穩定。
因此,內部一致性與重測信度回答的是不同問題。
高α不能證明量表具有時間穩定性。
二十、評分者間信度是什麼?
當研究資料需要由研究人員、專家或觀察員進行判斷時,必須檢查不同評分者是否給出一致結果。
例如:
- 兩位研究人員判斷藥局屬於哪一種經營型態。
- 三位專家評估選址地點的商圈成熟度。
- 兩位編碼員分析訪談內容的主題分類。
- 不同醫療人員評估個案的功能狀態。
如果同一個對象由不同評分者判定,結果差異很大,資料便可能受到評分者主觀判斷影響。
二十一、評分者間信度使用哪些指標?
指標應依資料類型選擇。
(一)百分比一致率
計算兩位評分者有多少比例作出相同判斷。
例如,100個案例中有85個分類一致:
$$ 一致率=\frac{85}{100}=85% $$
它很直觀,但沒有排除偶然一致的可能。
(二)Cohen’s κ
適用於兩位評分者對類別資料的評分,可校正偶然一致。
例如,兩位研究者把藥局分成:
- 社區型
- 門前型
- 母嬰型
可以使用Cohen’s κ評估一致性。
若類別具有順序,可以考慮加權κ,使相差一級與相差多級受到不同處理。
(三)Fleiss’ κ
常用於三位以上評分者的類別評分。
(四)組內相關係數
組內相關係數(ICC)常用於連續型評分,例如數位專家對每個地點給予0至100分的選址評分。
但是ICC具有不同模型與定義,例如:
- 單因子或雙因子模型
- 隨機效果或固定效果
- 一致性或絕對一致
- 單一評分者或平均評分
不同ICC可能得到不同結果。因此,論文不能只寫「ICC=.82」,還應說明使用哪一種ICC及選擇理由。
二十二、信度與樣本變異的關係
信度係數會受到樣本差異程度影響。
假設研究樣本中的受訪者都具有非常接近的系統信任程度,分數範圍很窄。即使量表測量誤差不大,題項之間的相關及信度係數仍可能較低。
相反地,如果樣本包含信任程度非常高與非常低的受訪者,分數差異較大,信度係數可能提高。
因此,不能只比較兩篇研究的α值,便斷定哪一份量表比較可靠。還要考慮:
- 樣本是否來自相似族群
- 分數範圍是否相近
- 題目數是否相同
- 題目是否被修改
- 施測情境是否相同
二十三、信度為什麼需要信賴區間?
研究中報告的α或ω,是根據特定樣本估計而來,也具有抽樣不確定性。
例如:
$$ \alpha=.81 $$
這只是點估計。若樣本很小,真正的不確定範圍可能很寬。
較完整的報告方式是:
$$ \alpha=.81,\quad 95%\ CI[.75,.86] $$
信賴區間可以幫助判斷:
- 信度估計是否精確。
- 樣本數是否足以提供穩定估計。
- 最低可能值是否仍能接受。
- 兩組信度差異是否可能只是抽樣波動。
因此,若統計軟體允許,建議同時報告信度係數及信賴區間。
二十四、刪題時可能產生的過度配適
如果研究者在同一份樣本中不斷進行以下操作:
- 計算α。
- 找出刪除後α上升的題目。
- 刪除該題。
- 再次計算α。
- 重複直到α變高。
最後得到的量表可能只適合目前這一份樣本。
這與建立預測模型時的過度配適類似:研究者利用樣本中的偶然特徵反覆調整量表,使結果看起來很好,但換一批受訪者後未必能重現。
較嚴謹的做法是:
- 題項修改與刪除應同時考慮理論。
- 探索性調整與正式驗證應使用不同樣本。
- 如果只能使用同一份樣本,應明確說明屬於探索性結果。
- 後續研究應以獨立樣本重新驗證。
二十五、常見信度分析流程
問卷資料完成整理後,可以依照以下順序進行信度分析。
第一步:確認題目及編碼
檢查:
- 哪些題目屬於同一構念?
- 哪些是反向題?
- 反向題是否已正確轉換?
- 遺漏值是否被正確定義?
- 是否出現超出量尺範圍的數值?
第二步:查看題目分布
檢查:
- 平均數與標準差
- 各選項次數
- 最低分與最高分比例
- 天花板或地板效應
- 是否存在幾乎沒有變異的題目
第三步:檢查題項相關
觀察:
- 題目是否大致呈正相關?
- 是否有異常負相關?
- 是否存在幾乎完全重複的題目?
- 平均題間相關是否合理?
第四步:計算內部一致性
可以報告:
- Cronbach’s α
- McDonald’s ω
- 信賴區間
第五步:檢查題項層級指標
包括:
- 修正後項目-總分相關
- 刪題後α或ω
- 各題對量表結構的影響
第六步:結合理論與因素結構
如果某題表現異常,應回頭檢查:
- 構念定義
- 題目語意
- 預試紀錄
- 因素負荷量
- 內容效度
最後才決定是否保留、修改或刪除。
二十六、論文中怎麼報告信度?
不建議只寫:
本研究各構面的Cronbach’s α均大於.70,顯示問卷具有良好信效度。
這句話有兩個問題:
- α只能提供內部一致性的資訊,不能證明效度。
- 沒有呈現每個構念的實際結果。
較完整的表格可以是:
| 構念 | 題數 | Cronbach’s α | McDonald’s ω | 修正後項目-總分相關範圍 |
|---|---|---|---|---|
| 知覺有用性 | 4 | .86 | .87 | .62~.75 |
| 知覺易用性 | 4 | .82 | .83 | .55~.70 |
| 系統信任 | 5 | .89 | .90 | .64~.79 |
| 使用意願 | 3 | .78 | .79 | .53~.66 |
文字可以寫成:
本研究分別評估各構念的內部一致性。知覺有用性、知覺易用性、系統信任與使用意願的Cronbach’s α介於.78至.89,McDonald’s ω介於.79至.90。各題的修正後項目-總分相關介於.53至.79,未發現負相關題項。結果顯示,各構念分數在本研究樣本中具有可接受至良好的內部一致性。
如果進行了刪題,則需另外說明:
- 刪除哪一題
- 統計證據
- 理論理由
- 是否在探索性或驗證性階段
- 刪題後構念內容是否仍完整
二十七、常見錯誤
信度分析中常見的錯誤包括:
- 把Cronbach’s α稱為問卷的「正確率」。
- 把α當成效度證據。
- 認為α大於.70就證明量表是單一構面。
- 將不同構念的所有題目一起計算一個總α。
- 忘記反向題重新編碼。
- 為提高α而機械式刪題。
- 忽略題數對α的影響。
- 只報刪題後α,不說明刪題的理論理由。
- 直接引用原研究的α,未在自己的樣本中重新估計。
- 認為量表的信度是永遠固定的。
- 用高內部一致性取代重測信度。
- 對評分資料只報相關,未評估評分者間一致性。
- 報告ICC卻沒有說明ICC類型。
- 只報點估計,完全忽略信賴區間。
- 在同一個樣本反覆刪題後,將結果當成已正式驗證。
二十八、本節重點
信度描述的是測量分數的一致性、穩定性或可重複程度。
不同類型的信度回答不同問題:
- 內部一致性:題項是否共同反映某個構念?
- 重測信度:不同時間的測量結果是否穩定?
- 評分者間信度:不同評分者的判斷是否一致?
Cronbach’s α是常見的內部一致性指標,但必須記住:
- α高不代表量表只有一個構面。
- α高不代表量表具有良好效度。
- α會受到題目數量影響。
- α過高可能表示題目重複。
- α低可能來自反向題錯誤、題目太少或構念混雜。
- 不能只為提高α而刪除題目。
McDonald’s ω可以考慮不同題目的因素負荷量,在許多情況下能提供比α更合理的內部一致性估計。但ω仍依賴合理的因素模型,不能取代效度與因素結構的檢查。
修正後項目-總分相關及刪題後α可以協助找出可能有問題的題目,但它們只是診斷線索,不是自動刪題規則。
最重要的是:
信度不是量表永久不變的標籤,而是特定量表分數在特定族群、時間與使用情境下所呈現的測量品質。
下一節將進一步討論效度,也就是:
即使量表能夠穩定地得到一致分數,我們如何證明它真正測到了研究者宣稱的構念?
留言
點擊「載入留言」後顯示 Disqus。