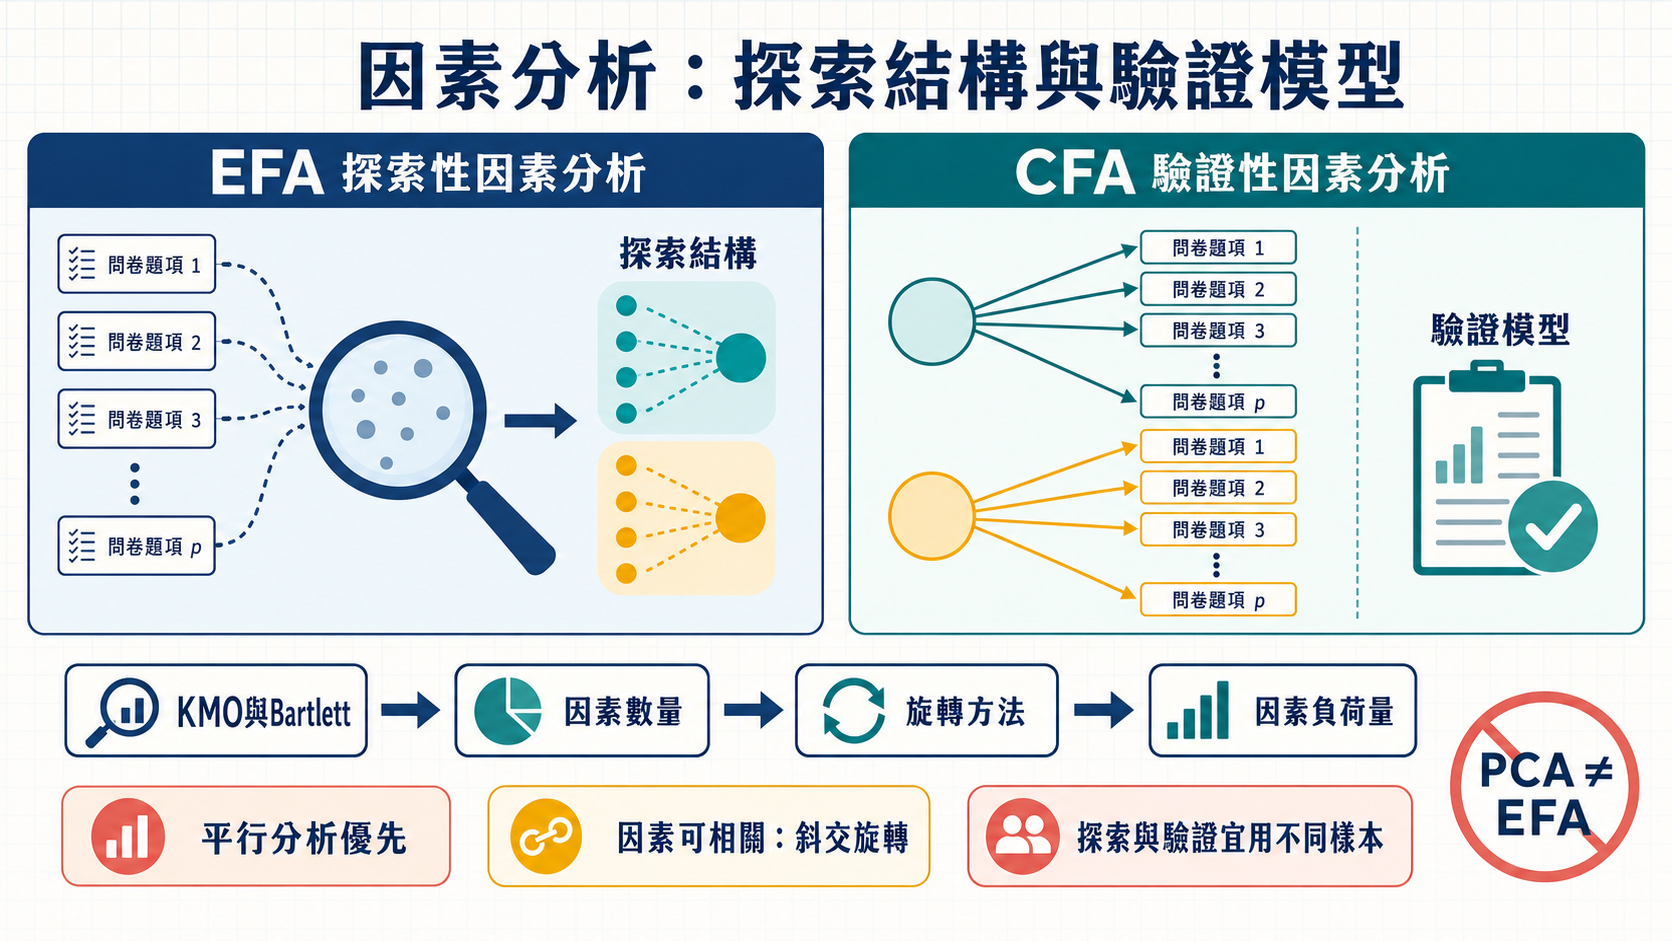
第二章第四節因素分析:題項背後究竟有幾個構念?
一組問卷題項背後,究竟反映一個構念,還是多個不同構念?
例如,研究者設計八道題目評估藥師對藥局選址系統的看法:
- 系統能提升選址效率。
- 系統能改善選址品質。
- 系統能幫助比較候選地點。
- 系統能降低資料蒐集時間。
- 系統操作方式容易理解。
- 系統功能容易學會。
- 系統介面容易操作。
- 我能快速熟悉系統功能。
從理論上來看,前四題可能測量「知覺有用性」,後四題可能測量「知覺易用性」。
但是,受訪者實際回答時是否真的會形成這兩組?還是所有題目都集中在同一個因素?又或者出現第三個未預期因素?
因素分析就是用來研究題項之間的共同變動,進一步探索或檢驗其背後潛在結構的方法。
一、什麼是因素分析?
因素分析是一組用來解釋多個觀察變項之間相關結構的統計方法。
問卷題目是可以直接觀察的變項。例如:
- 「系統能提升選址效率」的得分。
- 「系統容易操作」的得分。
- 「我願意繼續使用系統」的得分。
但「知覺有用性」「知覺易用性」與「使用意願」本身無法直接觀察,因此稱為潛在變項或因素。
因素分析的基本想法是:
題項之所以彼此相關,可能是因為它們共同受到某個潛在因素影響。
例如:
知覺有用性
├── 提升選址效率
├── 改善決策品質
├── 幫助比較地點
└── 減少蒐集時間
如果四道題目都受到知覺有用性影響,它們的回答便可能一起升高或降低。
二、因素分析的基本模型
共同因素模型可簡化表示為:
$$ X_i=\lambda_iF+\varepsilon_i $$
其中:
- (X_i):第 (i) 個觀察題項。
- (F):無法直接觀察的共同因素。
- (\lambda_i):因素負荷量。
- (\varepsilon_i):該題未被共同因素解釋的部分。
例如:
$$ 「系統提升選址效率」= \lambda\times「知覺有用性」+\text{其他影響} $$
這些「其他影響」可能包括:
- 題目特有內容
- 作答者當下狀態
- 題目理解差異
- 測量誤差
- 其他未納入模型的因素
因此,因素分析不是假設題目完全由構念決定,而是把題目變異分成共同部分與特有部分。
三、探索性因素分析與驗證性因素分析
因素分析最常見的兩種類型是:
- 探索性因素分析
- 驗證性因素分析
兩者都研究題項與潛在因素的關係,但目的及邏輯不同。
四、探索性因素分析
探索性因素分析(Exploratory Factor Analysis,EFA)適合在因素結構尚未確定時使用。
EFA主要回答:
- 題項背後可能有幾個因素?
- 哪些題目可能屬於同一因素?
- 某題是否同時與多個因素有關?
- 是否出現原先未預期的結構?
- 題項是否需要修改或重新分類?
在EFA中,研究者通常不會事先把每個題目完全限制在特定因素上,而是讓資料顯示可能的結構。
例如,原先推測八道題目可能形成「有用性」與「易用性」兩個因素。EFA結果可能發現:
- 題目1至4聚集在因素一。
- 題目5至8聚集在因素二。
這與理論預期一致。
但也可能發現:
- 題目1、2、3及5聚集在因素一。
- 題目4與因素一、因素二都有關。
- 題目6至8形成因素二。
此時研究者必須重新檢查題目4與題目5的內容,而不能只把結果硬套回原理論。
五、什麼時候適合使用EFA?
下列情況通常較適合EFA:
- 正在發展新量表。
- 構念結構尚不明確。
- 既有研究對因素數量沒有一致結論。
- 量表被大幅修改。
- 量表翻譯到新的文化或專業族群。
- 題項被應用到與原研究明顯不同的情境。
- 研究目的就是探索題項結構。
例如,研究者自行建立一份「藥師選址決策考量量表」,內容包含人口、競爭、診所、租金、交通與個人經驗等題目,但尚不確定它們會形成幾個構面。此時可以使用EFA進行初步探索。
六、驗證性因素分析
驗證性因素分析(Confirmatory Factor Analysis,CFA)適合在研究者已有明確理論或測量模型時使用。
CFA主要回答:
- 預先提出的因素結構是否與資料相容?
- 題目是否在預定因素上具有合理負荷?
- 不同因素是否能適當區分?
- 測量模型的整體適配情形如何?
- 某個競爭模型是否比另一個模型更合理?
例如,研究者根據科技接受模型提出:
- 題目1至4測量知覺有用性。
- 題目5至8測量知覺易用性。
- 兩個因素可以相關。
- 每個題目只由預定因素直接解釋。
CFA會評估這個事先提出的模型是否能合理說明實際資料。
七、EFA與CFA的核心差異
| 比較面向 | EFA | CFA |
|---|---|---|
| 中文名稱 | 探索性因素分析 | 驗證性因素分析 |
| 主要目的 | 發現可能的因素結構 | 檢驗預先提出的測量模型 |
| 理論要求 | 可以較初步,但仍需理論引導 | 必須有清楚理論或既有證據 |
| 題項歸屬 | 由資料協助探索 | 原則上事前指定 |
| 交叉負荷 | 通常允許估計 | 傳統CFA常限制為0 |
| 因素數量 | 需要探索與判斷 | 通常事前設定 |
| 常見階段 | 量表發展前期 | 量表驗證階段 |
| 主要輸出 | 因素數、負荷量、共同性、旋轉結果 | 負荷量、模型適配度、因素相關、殘差 |
| 結果性質 | 探索性 | 驗證性 |
最簡單的理解是:
EFA問「資料可能具有什麼結構?」;CFA問「我預先提出的結構是否與資料相容?」
八、同一份資料可以先做EFA再做CFA嗎?
技術上可以,但方法論上必須小心。
如果研究者:
- 在同一份資料中進行EFA。
- 根據結果刪除題目及調整因素。
- 再以相同資料進行CFA。
- 宣稱新結構已獲得驗證。
這種做法可能高估模型表現。
因為CFA使用的模型已經根據同一份資料調整過,再用相同資料檢驗,就像先看答案再參加考試。
較嚴謹的方法是:
方法一:使用兩個獨立樣本
- 樣本一進行EFA。
- 樣本二進行CFA。
方法二:將大樣本隨機分割
- 一部分作為探索樣本。
- 另一部分作為驗證樣本。
方法三:只有一份小樣本
可以進行EFA或CFA,但應誠實說明結果仍需由未來獨立樣本驗證,不能把同一樣本中的再次分析描述成完全獨立的驗證。
九、因素分析與主成分分析有什麼差別?
主成分分析(Principal Component Analysis,PCA)經常出現在統計軟體的因素分析選單中,因此容易與EFA混淆。
但兩者的目的並不完全相同。
主成分分析
PCA的主要目的是:
用較少的成分保留原始變項中的大部分資訊。
它使用題目的總變異,包括:
- 題目間共享的變異
- 題目特有的變異
- 測量誤差
PCA適合用於:
- 資料降維
- 壓縮大量指標
- 建立綜合指標
- 減少後續分析的變項數量
共同因素分析
EFA的共同因素模型主要關注:
題項之間共享的變異,是否可由較少的潛在因素解釋。
它試圖將共同變異與題目特有部分區分。
因此,若研究目的在於發展或檢查潛在構念量表,通常應考慮共同因素方法,例如:
- 主軸因素法
- 最大概似法
- 最小殘差法
而不是不加說明地直接使用PCA。
十、PCA完全不能使用嗎?
PCA不是錯誤方法,只是研究目的不同。
如果研究者想把人口數、診所數、交通流量、租金及商圈密度等多個客觀指標壓縮成少數綜合成分,PCA可能具有合理用途。
但如果研究者宣稱:
這些Likert題項反映一個無法直接觀察的心理構念。
那麼共同因素分析通常更符合測量模型的目的。
關鍵不是哪個方法比較高級,而是:
方法是否對應研究問題?
十一、進行EFA前要檢查什麼?
EFA不能只把資料丟進軟體後按下執行。分析前至少需要檢查:
- 題項是否適合共同分析
- 樣本數是否足夠
- 題項之間是否具有合理相關
- 是否存在嚴重離群值
- 資料是否過度偏斜
- 遺漏值如何處理
- 題項是否為次序資料
- 相關矩陣是否適當
- KMO是否合理
- Bartlett球形檢定是否提供支持
十二、KMO是什麼?
KMO是Kaiser–Meyer–Olkin取樣適切性指標。
它主要比較:
- 題項之間的簡單相關
- 控制其他題項後的偏相關
如果題項之間具有共同因素,題項應有一定相關;但控制共同影響後,偏相關通常不應過大。
KMO越高,表示題項之間的相關結構越可能適合使用因素分析。
常見參考方式如下:
| KMO | 常見初步解讀 |
|---|---|
| .90以上 | 非常良好 |
| .80~.89 | 良好 |
| .70~.79 | 尚可 |
| .60~.69 | 普通 |
| .50~.59 | 偏低 |
| 低於.50 | 可能不適合因素分析 |
這些仍是經驗性參考,不是絕對門檻。
除了整體KMO,也可以檢查每個題項的取樣適切性。如果某一道題目的指標特別低,可能代表它與其他題目的共同結構較弱。
但是,不能只因KMO偏低便機械式刪題。還應檢查:
- 題目內容
- 題項相關
- 樣本數
- 資料變異
- 構念是否包含多個面向
- 題項是否屬於錯誤構念
十三、Bartlett球形檢定是什麼?
Bartlett球形檢定用來檢驗相關矩陣是否與單位矩陣存在差異。
虛無假設大致是:
題項之間沒有足以進行因素分析的相關結構。
如果檢定結果顯著:
$$ p<.05 $$
表示題項相關矩陣不是單位矩陣,題項之間存在某些相關,可為進行因素分析提供初步支持。
但顯著的Bartlett檢定不代表:
- 因素模型一定良好。
- 題項一定形成單一因素。
- 題目一定具有收斂效度。
- 因素數量已經確定。
- 量表一定有效。
此外,Bartlett檢定對樣本數敏感。樣本很大時,即使題項相關很弱,也可能得到顯著結果。
所以:
KMO與Bartlett檢定只是分析前的適切性檢查,不是因素分析結果的合格證書。
十四、樣本數要多少才足夠?
因素分析沒有一個適用所有研究的固定樣本數門檻。
常見經驗法則包括:
- 至少100或200份樣本
- 每個題項需要5至10位受訪者
- 樣本數應為題項數的數倍
這些規則可以作為初步參考,但過度簡化。
實際需要的樣本數還受到以下因素影響:
- 因素數量
- 每個因素包含多少題
- 因素負荷量大小
- 共同性高低
- 因素間相關
- 題項分布
- 遺漏值比例
- 模型複雜程度
- 估計方法
- 資料是否近似連續
例如,如果每個因素都有多道高負荷題項,因素結構清楚,所需樣本可能較少;如果負荷量偏低、交叉負荷嚴重或每個因素只有少數題目,就需要更大的樣本。
較嚴謹的方法是根據預期模型進行模擬或檢定力分析,而不是只引用「每題五份樣本」。
十五、題項相關矩陣應該使用哪一種?
傳統因素分析常使用Pearson相關矩陣。但Likert題項本質上通常是次序資料,因此在以下情況下,Pearson相關可能不理想:
- 回答選項很少
- 分布嚴重偏斜
- 天花板或地板效應明顯
- 題項間關係不適合等距假設
此時可以考慮使用多分相關矩陣,也就是polychoric correlation。
簡單來說,polychoric相關假設觀察到的次序選項背後存在連續潛在反應,再估計兩者關係。
對五點或七點Likert題項而言,如果分布大致合理,許多研究仍使用Pearson相關;若選項少且偏態明顯,polychoric相關通常更值得考慮。
研究者應讓相關矩陣與資料性質相符,而不是完全依照軟體預設值。
十六、如何決定因素數量?
決定保留幾個因素,是EFA最重要的步驟之一。
不能只依賴單一方法。常見依據包括:
- 理論與構念定義
- 平行分析
- 碎石圖
- MAP檢驗
- 模型適配度
- 因素可解釋性
- 每個因素是否有足夠題項
- 不同因素解是否穩定
- 特徵值
十七、特徵值大於1的限制
傳統上常使用Kaiser準則:
保留特徵值大於1的因素。
這個方法操作簡單,但可能:
- 保留太多因素
- 保留太少因素
- 受到題目數量影響
- 受到樣本特徵影響
- 將隨機波動誤認為真正因素
因此,不應只因軟體顯示三個特徵值大於1,就直接宣稱量表具有三個因素。
十八、碎石圖如何判讀?
碎石圖將因素或成分依序排列,呈現特徵值下降情形。
研究者通常尋找曲線明顯由陡峭轉為平緩的「轉折點」。轉折點之前的因素可能具有較大解釋價值,後方則像山腳下的碎石。
但碎石圖的判斷可能具有主觀性:
- 有時轉折不明顯。
- 不同研究者可能選擇不同因素數。
- 樣本波動可能造成假轉折。
- 因素高度相關時可能難以判斷。
因此,碎石圖應搭配其他方法,而不是單獨決定因素數。
十九、平行分析是什麼?
平行分析會將實際資料的特徵值,與相同樣本數及變項數下隨機資料所產生的特徵值比較。
基本判斷是:
只有當實際資料的特徵值大於隨機資料的參考特徵值時,才考慮保留該因素。
假設結果如下:
| 因素 | 實際特徵值 | 隨機資料參考值 | 是否保留 |
|---|---|---|---|
| 1 | 4.80 | 1.40 | 是 |
| 2 | 2.10 | 1.28 | 是 |
| 3 | 1.15 | 1.19 | 否 |
| 4 | .82 | 1.12 | 否 |
雖然第三個因素的實際特徵值大於1,但仍低於隨機資料參考值,因此平行分析只支持保留兩個因素。
平行分析通常比單純使用特徵值大於1更可靠,因此應優先考慮。
但最終因素數量仍要兼顧理論、題目內容與因素可解釋性。
二十、什麼是因素萃取?
因素萃取是根據題項相關結構,估計潛在因素的過程。
常見方法包括:
主軸因素法
著重題項間的共同變異,常用於資料未完全符合多變量常態時。
最大概似法
能進行模型比較、信賴區間及統計檢定,但通常對分布假設要求較高。
最小殘差法
透過降低觀察相關與模型重建相關之間的差異估計因素,在EFA中也很常見。
不同方法可能產生略有不同的結果。研究者應說明選擇理由,而不是只接受軟體預設。
二十一、什麼是因素旋轉?
初步萃取因素後,因素負荷結構可能很難解釋。旋轉的目的是讓結果形成較清楚的簡單結構,使每道題目主要與少數因素相關。
旋轉不只是讓表格好看,而是協助解釋題項與因素的關係。
旋轉主要分為:
- 正交旋轉
- 斜交旋轉
二十二、正交旋轉
正交旋轉假設不同因素之間完全不相關。
常見方法是Varimax旋轉。
如果研究者有充分理論理由認為因素彼此獨立,可以考慮正交旋轉。
但是,在管理學、心理學與社會科學中,許多構念本來就可能相關。例如:
- 知覺有用性與使用意願
- 知覺易用性與知覺有用性
- 系統信任與採用意願
如果強迫這些因素完全不相關,可能無法合理反映資料結構。
二十三、斜交旋轉
斜交旋轉允許因素彼此相關。
常見方法包括:
- Oblimin
- Promax
對多數社會科學構念而言,斜交旋轉通常較符合現實。
使用斜交旋轉時,軟體可能同時提供:
- 型態矩陣
- 結構矩陣
- 因素相關矩陣
型態矩陣較接近控制其他因素後,題目與因素的獨特關係;結構矩陣則呈現題目與因素的整體相關。
研究者不能看到兩張不同矩陣就任意挑選較漂亮的一張,而應理解其意義並清楚報告。
二十四、如何選擇旋轉方法?
選擇旋轉方法的核心問題是:
理論上,不同構念是否可能相關?
如果可能相關,通常優先考慮斜交旋轉。
研究者可以先採斜交旋轉,查看因素間相關。如果相關確實接近零,再評估正交解是否具有合理性。
不建議只因Varimax是統計軟體的常見預設,就直接使用正交旋轉。
二十五、因素負荷量是什麼?
因素負荷量反映題項與因素之間的關係程度。
例如:
| 題項 | 有用性 | 易用性 |
|---|---|---|
| 系統提升選址效率 | .82 | .08 |
| 系統改善決策品質 | .78 | .12 |
| 系統幫助比較地點 | .75 | .15 |
| 系統容易操作 | .10 | .84 |
| 系統容易學習 | .14 | .80 |
| 系統介面清楚 | .22 | .68 |
理想的簡單結構通常是:
- 題目在預定因素上的負荷量較高。
- 在其他因素上的負荷量較低。
- 每個因素有數道具有實質意義的題目。
- 題目組合符合構念理論。
實務上常使用.30、.40、.50或.70作為不同程度的參考,但不能把某個數字當作所有研究的絕對刪題線。
負荷量的可接受程度受到以下因素影響:
- 樣本數
- 研究階段
- 題目數量
- 構念成熟程度
- 因素可解釋性
- 題目的理論重要性
- 是否存在交叉負荷
二十六、什麼是共同性?
共同性表示某個題項的變異中,有多少部分能被保留的共同因素解釋。
假設某題共同性為:
$$ h^2=.64 $$
可理解為保留的因素共同解釋了該題約64%的變異。
剩餘約36%可能包含:
- 題目特有變異
- 測量誤差
- 未納入的其他因素
共同性很低,可能表示:
- 該題與其他題目的共同結構較弱。
- 保留的因素數量不足。
- 題目測量不同內容。
- 題目表達不清。
- 資料品質有問題。
但低共同性仍不是自動刪題規則。研究者需要結合理論與其他指標判斷。
二十七、什麼是交叉負荷?
交叉負荷是指某一道題目同時在兩個以上因素具有明顯負荷。
例如:
| 題項 | 有用性 | 易用性 |
|---|---|---|
| 系統讓選址工作變得更容易 | .55 | .52 |
這道題同時與有用性及易用性相關,可能是因為「更容易」可以被理解為:
- 提高工作效果
- 降低操作難度
因此,交叉負荷可能反映題目語意本身同時涉及兩個構念。
處理方式可以包括:
- 重新檢查題目文字。
- 檢查題目是否包含兩個概念。
- 參考原量表與理論定義。
- 在後續研究修改題目。
- 評估保留或刪除對內容效度的影響。
- 使用CFA或其他模型進一步檢驗。
不能只因某題交叉負荷,就在沒有理論理由的情況下刪除。
二十八、每個因素至少需要幾道題?
一般而言,每個因素最好有多道題目共同測量。
只有一道題目的因素無法估計內部一致性,也難以區分構念變異與題目特有誤差。
兩題因素有時可以使用,但模型可能不夠穩定,且需要較強理論與其他限制。
三題通常被視為辨識因素的基本起點,但並不代表三題一定足夠。
因素穩定性還取決於:
- 題項負荷量
- 題目品質
- 樣本數
- 因素間相關
- 模型設定
- 是否具有清楚理論
不能只為了湊足三題而保留內容不合理的題目。
二十九、CFA主要檢查什麼?
CFA通常評估兩個層次。
題項層次
- 因素負荷量
- 標準誤
- 顯著性與信賴區間
- 殘差
- 題項解釋變異
- 異常估計值
模型層次
- 整體模型適配度
- 因素間相關
- 收斂效度
- 區辨效度
- 競爭模型
- 模型識別與估計是否合理
CFA不是只看一個適配度指標,而是綜合多項證據判斷模型與資料的相容程度。
三十、常見CFA適配度指標
常見指標包括:
- 卡方檢定
- CFI
- TLI
- RMSEA
- SRMR
卡方檢定
檢驗模型所隱含的共變異矩陣是否與觀察資料一致。
卡方檢定容易受到樣本數影響。樣本很大時,即使差異很小,也可能顯著。因此,不能只因卡方檢定顯著就立即否定模型。
CFI與TLI
比較研究模型與基準模型的改善程度。數值越高通常代表適配較好。
RMSEA
反映模型在母體中的近似誤差,通常應搭配信賴區間報告。
SRMR
反映觀察相關與模型估計相關之間的標準化殘差。
研究中常出現固定門檻,例如CFI高於.90或.95、RMSEA低於.08或.06。但這些都是經驗性參考,不應機械式套用。
適配度判斷還要考慮:
- 模型複雜度
- 樣本數
- 自由度
- 資料分布
- 估計方法
- 模型是否具有理論意義
- 局部適配是否存在問題
三十一、模型適配良好代表理論正確嗎?
不代表。
一個模型與資料適配良好,只能表示:
目前沒有足夠證據顯示模型與觀察資料嚴重不相容。
它不能證明:
- 模型是唯一正確模型。
- 理論因果關係成立。
- 所有題目都沒有問題。
- 量表適用於所有族群。
- 其他競爭模型一定比較差。
不同模型有時可能產生相近的適配度。因此,CFA必須結合理論與競爭模型比較,不能把適配指標當成理論真假的裁判。
三十二、什麼是修正指標?
CFA軟體常提供修正指標,提示如果:
- 讓某題跨負荷到另一因素
- 允許兩題殘差相關
- 增加某條參數路徑
模型適配度可能改善多少。
修正指標可以協助發現模型錯誤,但非常容易被濫用。
例如,研究者不斷依照修正指標加入殘差相關,直到CFI及RMSEA達到理想門檻。最後模型可能非常適合目前樣本,卻失去理論意義,也無法在其他樣本重現。
只有在具有明確理由時才應調整,例如:
- 兩道題目文字高度相似。
- 兩題具有相同題幹。
- 兩題都是反向題。
- 兩題共享特定方法效果。
- 理論本來就預期存在額外關係。
即使如此,也應在獨立樣本中重新驗證。
三十三、Likert題項進行CFA時要注意什麼?
Likert題項通常屬於次序資料。若題目選項少、分布偏斜或天花板效應明顯,直接使用假設連續與常態的最大概似估計可能不理想。
此時可考慮適合次序資料的估計方法,例如:
- WLSMV
- DWLS
- 穩健估計方法
並使用多分相關矩陣。
如果題項有五點或七點、分布大致合理且樣本適當,研究者有時仍將其近似視為連續資料,使用穩健最大概似估計。
選擇時應考慮:
- 選項數量
- 分布偏態
- 樣本數
- 模型複雜度
- 軟體功能
- 估計方法假設
論文中應清楚報告使用的相關矩陣及估計方法。
三十四、量表平均分數應在何時建立?
如果量表結構尚未確認,就直接將題目加總或取平均,可能把不同構念混在一起。
較合理的順序是:
- 根據理論決定題項與構念。
- 完成反向計分及資料檢查。
- 評估因素結構。
- 檢查信度與效度。
- 確認題項可以形成量表。
- 再建立總分、平均分數或潛在變項分數。
- 進行後續相關、迴歸或結構模型分析。
如果使用CFA或結構方程模型,也可以直接以潛在變項進行分析,保留題項測量誤差,而不一定先建立簡單平均分數。
三十五、因素分析能證明因果關係嗎?
不能。
因素分析研究的是題項之間的共變異結構。它不能證明:
- 潛在因素造成題項回答。
- 一個構念造成另一個構念。
- 問卷分數代表真實因果機制。
- 不同因素的時間順序。
即使CFA模型使用單向箭頭表示潛在因素指向題項,這首先是測量模型的統計表示,不能單靠橫斷面問卷證明心理因果過程。
三十六、因素分析與信度、效度的關係
因素分析與信度、效度有關,但不能彼此取代。
信度
檢查分數是否具有合理一致性與穩定性。
因素分析
檢查題項背後的結構是否合理。
效度
評估對量表分數的解釋與用途是否有足夠證據支持。
例如,高Cronbach’s α不能證明量表只有一個因素;EFA發現單一因素也不能證明所有效度;CFA適配良好也不能證明量表在其他族群同樣適用。
它們是相互關聯但不同的證據。
三十七、EFA的建議流程
可以依照以下順序進行EFA:
- 根據理論界定構念與題項。
- 檢查題目編碼及反向計分。
- 檢查遺漏值與題項分布。
- 判斷使用Pearson或polychoric相關。
- 評估樣本與相關矩陣是否適合。
- 查看KMO及Bartlett檢定。
- 選擇共同因素萃取方法。
- 使用平行分析、碎石圖及理論判斷因素數量。
- 根據因素相關可能性選擇旋轉方法。
- 檢查因素負荷量、共同性及交叉負荷。
- 評估每個因素的理論意義。
- 檢查不同因素解是否穩定。
- 對刪題與修改保留完整紀錄。
- 使用獨立樣本進行CFA。
三十八、CFA的建議流程
CFA可以依照以下順序進行:
- 根據理論事先提出測量模型。
- 確認每個因素包含哪些題項。
- 檢查資料尺度、分布與遺漏值。
- 選擇適當的相關矩陣與估計方法。
- 確認模型可以識別。
- 檢查是否出現不合理估計值。
- 評估因素負荷量。
- 綜合判斷整體與局部適配。
- 評估內部一致性及收斂效度。
- 評估區辨效度。
- 比較理論上合理的競爭模型。
- 只在具有理論理由時參考修正指標。
- 對任何模型調整保持透明。
- 優先以獨立樣本驗證修改後模型。
三十九、EFA結果如何報告?
論文中至少應說明:
- 研究目的
- 樣本數
- 題項數
- 遺漏值處理
- 使用的相關矩陣
- 因素萃取方法
- 因素數量決定方式
- 旋轉方法
- KMO
- Bartlett球形檢定
- 保留因素數
- 因素負荷量
- 共同性
- 交叉負荷處理
- 刪題理由
- 各因素的理論命名
範例:
本研究以探索性因素分析評估題項的潛在結構。考量題項採五點Likert量尺,並呈現部分偏態,分析採用多分相關矩陣及最小殘差萃取法。整體KMO為.84,Bartlett球形檢定達顯著水準,顯示相關矩陣具有進行因素分析的基本條件。因素數量依平行分析、碎石圖及理論可解釋性綜合判斷,保留兩個因素,並採允許因素相關的Oblimin旋轉。保留題項的主要因素負荷量介於.58至.86,未發現嚴重交叉負荷。兩個因素依題項內容命名為知覺有用性與知覺易用性。
不能只寫:
KMO大於.80且Bartlett檢定顯著,因此本量表具有良好效度。
KMO與Bartlett檢定只說明資料具備初步分析條件,不能單獨證明效度。
四十、CFA結果如何報告?
論文中至少應說明:
- 理論模型
- 樣本數
- 題項性質
- 使用的估計方法
- 遺漏值處理
- 模型識別方式
- 因素負荷量
- 模型適配度
- 因素相關
- 信度
- 收斂效度
- 區辨效度
- 模型調整及理由
- 是否使用獨立樣本驗證
範例:
本研究以驗證性因素分析檢驗三因素測量模型,三個潛在構念分別為知覺有用性、系統信任與使用意願。考量題項為五點次序尺度,採用適合次序資料的穩健估計方法。各題標準化因素負荷量介於.62至.88,模型整體適配指標大致支持預定結構。各構念的組合信度及平均變異萃取量提供收斂效度證據;HTMT結果亦支持三個構念具有一定區辨性。所有模型設定與調整均根據理論及題項內容進行。
四十一、因素負荷量表格範例
| 題項 | 知覺有用性 | 知覺易用性 | 共同性 |
|---|---|---|---|
| PU1 提升選址效率 | .82 | .08 | .69 |
| PU2 改善決策品質 | .78 | .12 | .64 |
| PU3 幫助比較地點 | .75 | .15 | .61 |
| PU4 減少蒐集時間 | .68 | .18 | .53 |
| PE1 容易操作 | .10 | .84 | .72 |
| PE2 容易學習 | .14 | .80 | .67 |
| PE3 介面清楚 | .22 | .68 | .55 |
| PE4 容易熟悉 | .18 | .73 | .59 |
表格應註明:
- 使用的萃取方法
- 使用的旋轉方法
- 是否隱藏低於某數值的負荷量
- 顯示的是型態矩陣還是結構矩陣
- 因素數如何決定
四十二、常見錯誤
因素分析常見的錯誤包括:
- 把PCA直接稱為EFA。
- 不說明因素萃取方法。
- 只使用特徵值大於1決定因素數。
- 只看碎石圖,不考慮理論與平行分析。
- 因素可能相關,卻直接使用Varimax旋轉。
- 只因KMO大於某個數值就宣稱量表有效。
- 把Bartlett檢定顯著解釋為因素結構良好。
- 看到低因素負荷便自動刪題。
- 為追求簡單結構而反覆刪題。
- 忽略交叉負荷的語意與理論原因。
- 把高Cronbach’s α當成單一因素證據。
- 在同一樣本進行EFA與CFA後宣稱完成獨立驗證。
- 只報告CFA適配指標,不報因素負荷量。
- 依修正指標大量加入殘差相關。
- 只要CFI或RMSEA通過門檻,就宣稱模型正確。
- 將Likert題項一律當成常態連續資料。
- 不說明估計方法與遺漏值處理。
- 只報最後模型,隱藏刪題與修改過程。
- 把因素分析結果解釋成因果證據。
- 只追求統計結構漂亮,忽略內容效度。
四十三、本節重點
因素分析用來研究多個題項之間的共同結構,以及其背後可能存在的潛在因素。
EFA的目的
探索資料可能具有的因素結構,適合量表發展初期、結構不明或量表被大幅修改的情況。
CFA的目的
檢驗事先根據理論提出的測量模型是否與資料相容,適合量表驗證階段。
進行因素分析時,需要注意:
- KMO與Bartlett檢定只是資料適切性的初步檢查。
- PCA與共同因素分析的目的不同。
- 因素數量應結合理論、平行分析、碎石圖及可解釋性。
- 旋轉方法應根據因素是否可能相關選擇。
- 因素負荷量、共同性及交叉負荷都必須結合理論判斷。
- 固定門檻只能作參考,不能取代研究判斷。
- EFA探索出的模型最好用獨立樣本進行CFA。
- CFA適配良好不代表模型或理論已被證明。
- 修正指標不能成為無限制修改模型的工具。
- 因素分析不能證明因果關係。
最重要的是:
因素分析不是把題目丟進軟體,讓系統自動決定構念;而是讓理論、題項內容與資料結構彼此對話的過程。
完成本節後,應能分辨EFA與CFA的目的,理解KMO、Bartlett檢定、因素負荷量、共同性與交叉負荷,並能根據理論、平行分析及碎石圖合理判斷因素結構。
留言
點擊「載入留言」後顯示 Disqus。